Un crawler, detto anche spider o robot, è un programma automatico che visita le pagine web seguendo i link per leggerne il contenuto, per esempio per conto di un motore di ricerca. Per chi ha un sito la regola è semplice: se il crawler non riesce ad arrivare a una pagina o a leggerla, quella pagina non può comparire nei risultati organici.
Faccio SEO dal 2009 e il primo controllo che faccio su un sito che non si posiziona è se i crawler riescono a entrarci. Ho riscritto questa voce a ottobre 2026: ho tolto un’imprecisione (il crawler non salva solo il testo) e corretto il nome del file, che è robots.txt e non “robot.txt”.
Come funziona
Il lavoro del crawler ha tre passaggi:
- Scoperta. Parte da indirizzi già noti, come le pagine già visitate e quelle indicate nelle sitemap, e segue i link che trova.
- Scansione (crawling). Scarica la pagina, come farebbe un browser, con testo, immagini e il codice che serve a disegnarla.
- Indicizzazione. I contenuti passano al sistema che decide se e come salvarli nell’indice del motore.
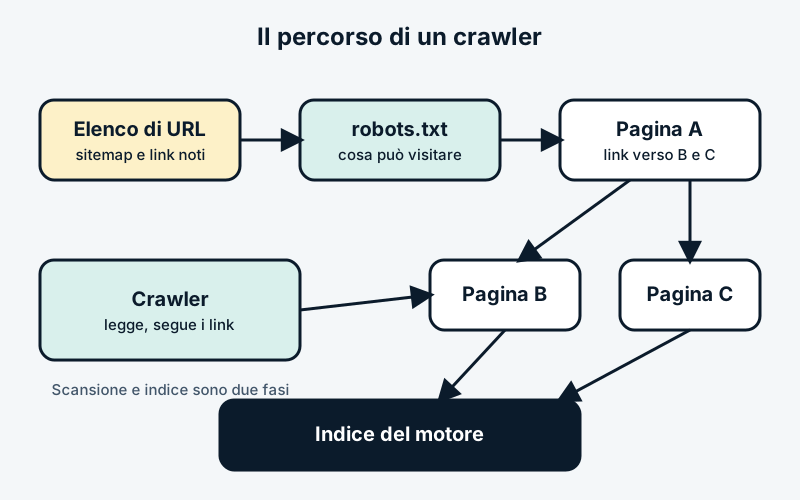
Scansione e indicizzazione sono due fasi diverse: una pagina può essere visitata e non finire nell’indice. Google descrive i suoi crawler, tra cui Googlebot, in questa pagina. Per il quadro generale leggi come funzionano i motori di ricerca.
Cosa c’entra con la SEO
- Link interni. Il crawler si muove sui link: una pagina che non è collegata da nulla è difficile da trovare.
- Sitemap. Un file che elenca gli indirizzi che vuoi far scoprire. Google la spiega nella guida alle sitemap.
- robots.txt. File nella radice del dominio con cui chiedi ai crawler di non visitare certe parti. La guida di Google è qui.
- Velocità e errori. Un sito lento o con errori del server viene visitato meno.
- Crawl budget. È il numero di pagine che Google è disposto a scansionare sul tuo sito. Per un sito piccolo non è un problema, per uno con centinaia di migliaia di pagine sì (guida di Google).
Attenzione: il robots.txt non serve a nascondere una pagina dai risultati. Se è bloccata ma altri siti la linkano, l’indirizzo può comparire lo stesso, senza descrizione. Per non farla indicizzare usa il tag noindex e non bloccare la scansione, altrimenti il crawler non lo legge.
Esempio pratico
Hai un sito nuovo e dopo un mese Google non mostra nessuna pagina. Controllo tre cose: che il robots.txt non contenga un divieto per tutto il sito (capita dopo la fase di prova), che il sito non abbia l’opzione “scoraggia i motori di ricerca” attiva e che la sitemap sia stata inviata in Search Console. Se è tutto a posto, vedo gli errori nel rapporto di indicizzazione. Per i passi successivi leggi come indicizzare un sito.
Errori comuni
- Lasciare il sito bloccato dopo la messa online.
- Bloccare CSS e JavaScript, così Google non vede la pagina come la vedi tu.
- Usare robots.txt per proteggere dati riservati. Il file è pubblico: serve una password.
- Confondere crawler e visitatori. Nelle statistiche i bot possono falsare i numeri.
Oggi
Oltre a Googlebot ci sono i crawler di Bing, degli strumenti SEO e delle aziende di intelligenza artificiale, e puoi decidere se farli entrare indicandolo nel robots.txt, ciascuno con il proprio nome. È una scelta di strategia, non solo tecnica: ne parlo in SEO 2026 e ottimizzazione per l’AI. Un buon audit SEO parte sempre da una scansione del sito, con un crawler come quelli degli strumenti professionali.
Vuoi sapere se Google riesce a leggere tutte le tue pagine importanti? Scrivimi con sito e obiettivi e ne parliamo in videochiamata. Per il quadro generale leggi la guida al posizionamento su Google.
Domande frequenti
Cos’è un crawler?
È un programma automatico che naviga il web seguendo i link da una pagina all’altra e ne legge il contenuto. Quello di Google si chiama Googlebot; esistono crawler anche per Bing, per gli strumenti SEO e per l’intelligenza artificiale.
Qual è la differenza tra crawler e spider?
Nessuna sostanziale: sono due nomi dello stesso tipo di software, insieme a robot e bot. In SEO si usano come sinonimi.
Come blocco un crawler su una pagina?
Con il file robots.txt chiedi ai crawler di non visitare certe pagine. Ma non è un modo sicuro per toglierle dai risultati: per non farle indicizzare serve il tag noindex, oppure una protezione con password.
Come faccio sapere a Google che ho nuove pagine?
Basta che siano collegate da altre pagine del sito. Puoi aiutare inviando la sitemap in Search Console e richiedendo l’indicizzazione di un singolo indirizzo con lo strumento di controllo URL.